DeepSeek“帕累托改进图”刷屏AI圈
21世纪经济报道记者 赵云帆
虽然DeepSeek过去并没有承认,但AI开发者社区一直把拥有极致性价比的DeepSeek模型,比作其余模型的“斩杀线”。
但最近,就连DeepSeek官方也开始呼应这种市场定位。
10月17日,DeepSeek V4.1-Flash-1017版本官宣更新。与过去发布聚焦技术与工程阐释的“学术风”不同,此次DeepSeek官方不仅骄傲地官宣新版本的模型完成了“帕累托改进”,其更是放出一张基准测试成本对比的散点图,暗示新版本的性价比在友商中“一骑绝尘”。
换句话说,这可能是DeepSeek官方最接近承认自己是AI大模型“斩杀线”的一次发布。
火药味十足的“帕累托改进”
所谓“帕累托改进”,即社会福利经济学中的基础概念,指在无任何经济参与者受损的情况下带来整体社会福利的上升。引申到大模型领域,“帕累托改进”或指在大模型使用成本没有提高的前提下,所有使用状况的效益都得到了提高。
记者注意到,这是DeepSeek首次在官方文献中宣传自家大模型完成了“帕累托改进”。
与“帕累托改进”并列的一个概念叫做“帕累托最优”,其指在所有可选择的分配方式下,某一种分配方式实现了社会效益的“最优解”。
而在DeepSeek本次发布的语境下,这家中国知名的开源模型企业,无疑是将自己列为了“最优解”之一。
在DeepSeek此次发布的通稿中,V4.1-Flash-1017火药味十足地将当下受众最广和最具代表性的大模型——月之暗面Kimi K3、智谱GLM5.3、OpenAI GPT5.6和Anthropic Claude Opus 5拉入基准竞技场。
而根据DeepSeek自行测试的基准通过率,DeepSeek V4.1-Flash-1017在11项智能体基准测试中的4项夺魁。
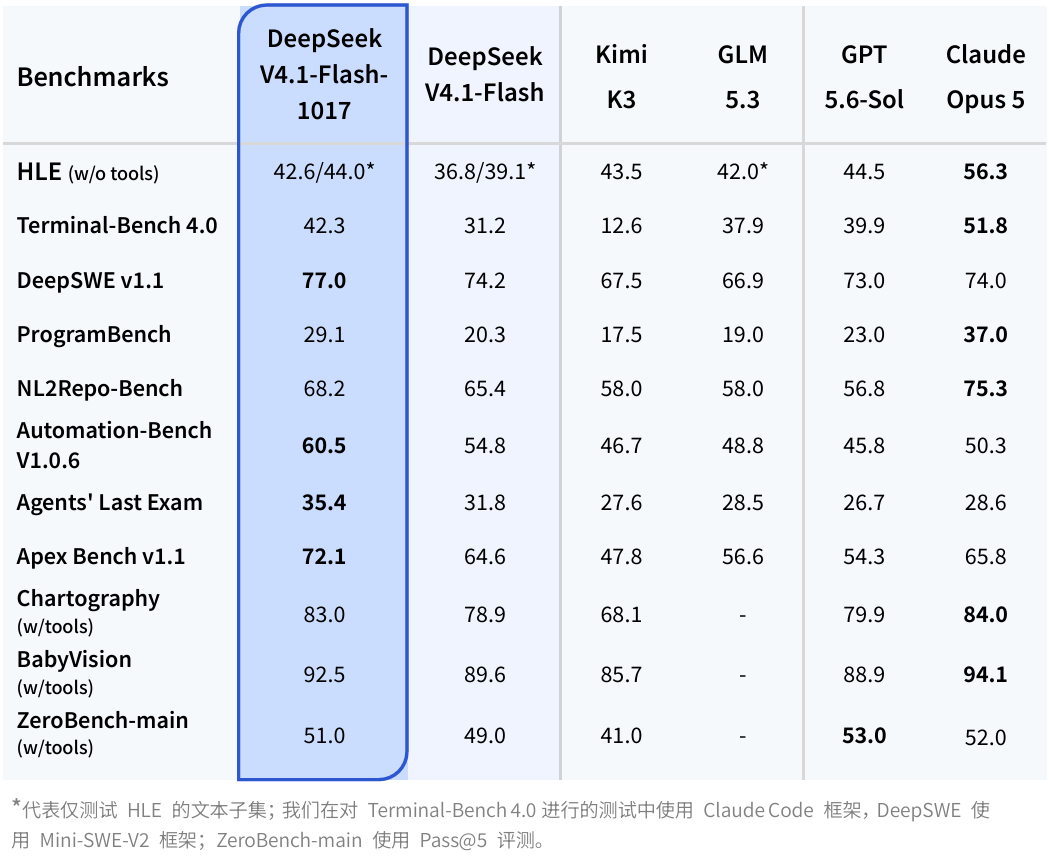
当然,这并不是DeepSeek此次发布的核心——这家大模型企业真正想传达的东西,藏在下面这张散点图中。
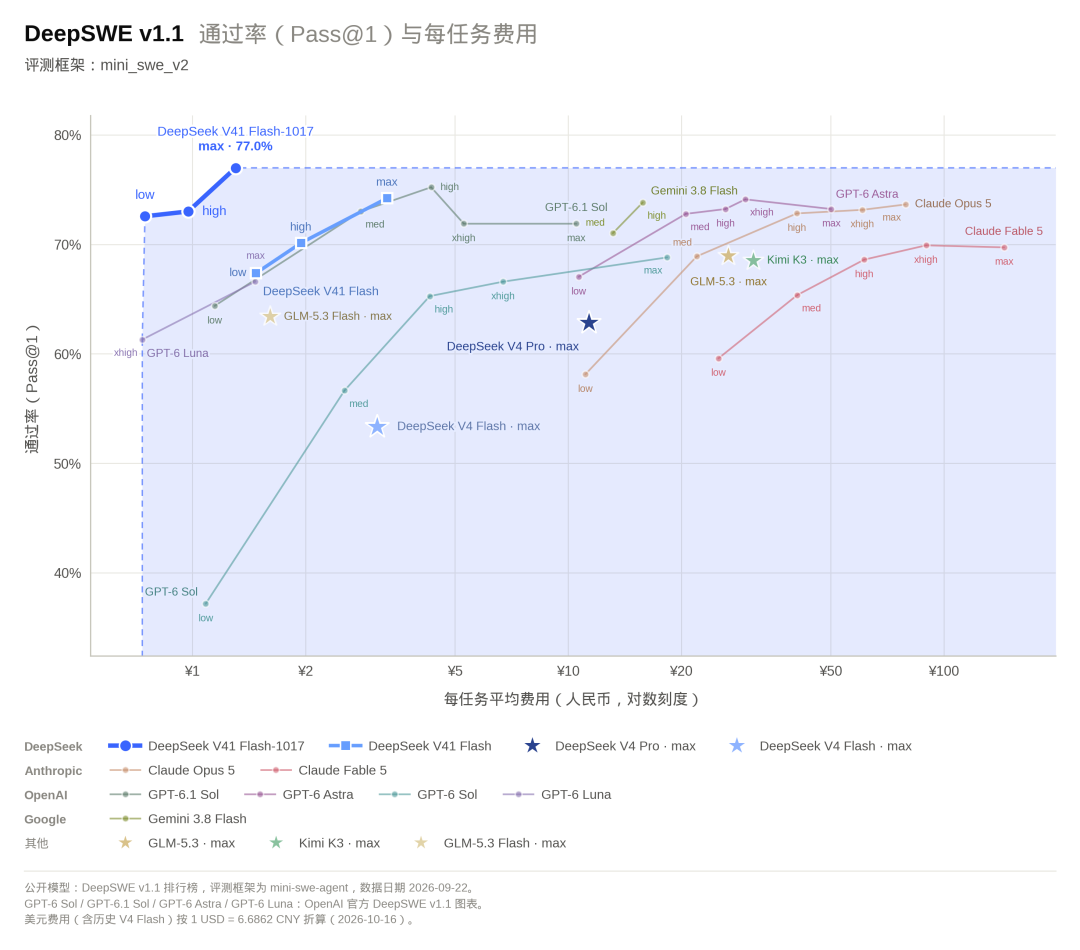
在这张“价格-基准通过率”的坐标轴中,DeepSeek拉入了更多一度获得“SOTA(即顶尖模型)”的头部大模型,包括刚发布的GPT-6系列Astra、Luna、6.1Sol,霸榜一时的Claude Fable 5等,并按照不同的模型使用强度计入通过率和词元消耗。
按照该坐标轴的含义,越靠左的模型使用价格越便宜,越靠上的模型性能越好;与此同时,越靠近左上角的模型,越拥有更高的性价比;越靠近右下角的模型,则说明其在市场上没有竞争力。
显而易见,在DeepSeek自己的基准测试中,V4.1-Flash-1017的表现被高悬于左上角,是那个又便宜又好用的“帕累托最优”;同时,V4.1-Flash-1017在不同使用强度的表现上斜率显著低于其余“友商”,其指代新版模型在低强度模式之下的可用性和性价比都很高。
无形中,DeepSeek似乎也在向外界回应自己那个被叫做“斩杀线”的江湖诨名。
“这张图可能会在未来一段时间火起来,DeepSeek希望以这种方式再次加深大家对这家公司的印象,即便没有人会完全认可这张图上的数据。”一位AI算法工程师在社交平台上评价。
锁定性价比,目标“普惠”
对于DeepSeek官方使用“帕累托改进”自夸,还用图示“讽刺”前沿模型没有价格优势的做法,开发者社区的评价呈分化状态。
比如,部分开发者实测,DeepSeek确实做到了“花零头的钱,干旗舰的活”;部分独立OPC实测使用DeepSeek开发,成本被降到了前沿模型的1/2甚至1/3等。
10月19日,知名AI中转站Vercel AI发布了最新网关指数显示,9月份,DeepSeek旗下模型处理了该中转站58%的词元,但只占用了全站6.6%的费用;其中仅V4.1-Flash模型就消耗了中转站50%的词元,却仅占用了全站2.6%的费用。
当然,对新版的质疑声依旧不少:部分开发者实测,在部分困难任务下,高强度使用DeepSeek不仅无法完美完成任务,其费用甚至还比GPT-6、Fable等“SOTA”模型更高。
还有部分开发者断言DeepSeek在给老版本模型“降智”,以让新版本看起来更聪明。
就在上周,DeepSeek经历了史上时间跨度最长的宕机危机。在新版本V4.1-Flash-1017发布之后,用户实测新版模型依然存在卡顿严重的情况。
当然,如果DeepSeek只是希望夯实自身的“性价比”定位,那他们似乎又成功了一次。
在此次发布中,DeepSeek宣传新版模型已经可以做到“许愿式编程”。部分用户实测发现,在许多基础性的、较为独立的代码考题中,比如做一个小游戏、一个功能性演示等,DeepSeek确实可以具备比肩“SOTA”的能力。但对于企业级与系统级编程的考题,开发者普遍反馈新模型无法实际完成任务。
这也触及一个行业的普遍认知:DeepSeek的代码能力在实际工程可用性上,与当前“SOTA”模型仍有明显差距。
但是,当Anthropic和OpenAI在今年运用顶尖模型的代码能力获得程序员青睐的同时,普通使用者通过AI编程完成自动化智能助理的“下沉需求”,在AI动态编程不断迭代的今天,仍然无法被真正满足。而在这背后,开发一款能够实际应用的软件需要经过多轮的调试,其开发隐性成本远高于一两轮对话。
对于即将完成新一轮融资,并且明确瞄准IPO的DeepSeek来说,通过低成本调用,锁定最海量的用户,形成模型使用的广泛生态,成为了帮助其锚定估值的关键。
10月20日,DeepSeek发布官方公告,将推理框架“DeepInfer”全面开源,并表达了“走向真正普惠的未来”的愿景。
公司表示,希望通过分享内部的部署经验,帮助开发者与企业组织优化大规模推理的吞吐与延迟,从而高效构建私有化及公有云部署,降低算力成本、减少能源消耗,让智能以更低的价格触达更广泛的人群,实现真正的大模型普惠。


